Riset Apple Minions Manfaatkan Mac Menganggur sebagai Komputasi AI Terdistribusi
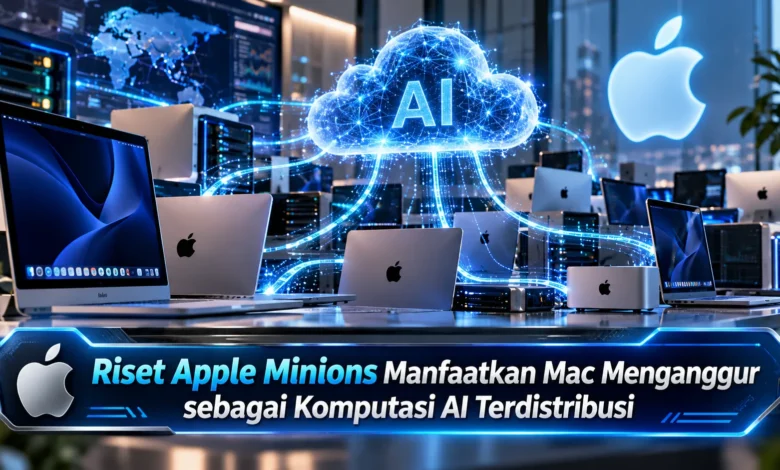
Apple mengembangkan pendekatan baru untuk memanfaatkan komputer Mac yang sedang tidak digunakan melalui sistem komputasi terdistribusi bernama Minions. Penelitian yang dipublikasikan pada Oktober 2026 ini memperlihatkan bagaimana GPU pada perangkat berbasis Apple Silicon dapat digabungkan menjadi sumber daya komputasi virtual untuk menjalankan tugas kecerdasan buatan. Inovasi TEKNOLOGI tersebut bertujuan mengurangi ketergantungan terhadap infrastruktur GPU terpusat yang sering menghadapi antrean pekerjaan dan biaya operasional tinggi. Dengan memanfaatkan kapasitas perangkat yang sudah tersedia, Minions menawarkan cara berbeda dalam mengelola inferensi AI, meningkatkan efisiensi penggunaan perangkat keras, dan mendistribusikan pekerjaan komputasi.
Inovasi Apple Memanfaatkan GPU Mac sebagai Cloud Virtual
Pertumbuhan ekosistem komputasi AI mendorong pertumbuhan permintaan kapasitas pemrosesan yang mampu menangani sistem pembelajaran mesin modern. Dalam praktik yang banyak digunakan, pemrosesan AI sering bergantung pada server GPU terpusat. Meskipun pusat data menyediakan daya komputasi tinggi, kapasitas akselerator dapat menjadi terbatas. Kondisi tersebut berpotensi menimbulkan antrean pekerjaan ketika banyak pengguna membutuhkan komputasi secara bersamaan. Menanggapi tantangan ini, peneliti Apple merancang sistem Minions yang memanfaatkan GPU Mac dalam kondisi menganggur.
Minions diperkenalkan melalui penelitian berjudul Minions: A Dynamic and Distributed Virtual GPU Cloud Built on Idle Apple Silicon Devices yang diperkenalkan melalui publikasi akademis pada Oktober 2026. Publikasi dari tim Apple tersebut menjelaskan cara mengumpulkan kapasitas akselerasi komputasi macOS menjadi infrastruktur pemrosesan bersama. Daripada menambah server khusus untuk setiap kebutuhan, organisasi mampu memanfaatkan kapasitas komputasi yang belum terpakai. Strategi pemrosesan ini diharapkan membantu memperbaiki efisiensi operasional. Namun demikian, Minions belum menjadi layanan publik untuk seluruh pemilik Mac.
Cara Kerja Sistem Minions dalam Membagi Pekerjaan AI
Infrastruktur virtual GPU cloud tersebut bekerja dengan menggabungkan beberapa perangkat Mac yang menyediakan sumber daya grafis menganggur. Ketika tugas AI dikirimkan, sistem memecah permintaan ke dalam sejumlah subtugas. Subtugas tersebut kemudian diproses oleh Mac yang memiliki sumber daya. Berkat distribusi pekerjaan tersebut, beberapa komputer dapat berkontribusi pada beban kerja bersama. Ketika subtugas berhasil dijalankan, informasi hasil pemrosesan dikirimkan kembali. Pada tahapan akhir, sistem menyelesaikan pekerjaan berdasarkan subtugas yang telah diproses.
Keunggulan rancangan yang menarik Minions adalah model distribusi pekerjaan berbasis penarikan. Sebagai alternatif terhadap scheduler yang menugaskan setiap mesin secara langsung, komputer yang memiliki kapasitas menganggur meminta tugas berikutnya kepada server. Pendekatan tersebut membantu menghadapi perubahan ketersediaan perangkat. Untuk menggambarkan penerapannya, sebuah Mac berpotensi menyediakan kapasitas saat tidak digunakan secara intensif. Apabila pemilik mulai menjalankan pekerjaan berat, sistem harus menyesuaikan penggunaan sumber daya. Karena itu, penjadwalan dinamis menjadi kebutuhan penting.
Bagaimana Apple Mengelola Pekerjaan GPU di Banyak Mac
Dalam arsitektur Minions, Apple mengembangkan bagian sistem yang saling bekerja sama, termasuk Minion Server, Minion Executor, dan Minion Watchdog. Layanan koordinasi Minions berperan dalam membagi permintaan komputasi menjadi unit kerja yang lebih kecil. Adapun pada komputer Mac, Minion Executor mengelola pelaksanaan subtugas pada mesin lokal. Executor pada masing-masing Mac memanfaatkan GPU Apple Silicon untuk menghasilkan keluaran inferensi. Layanan watchdog sistem digunakan untuk mendukung keandalan eksekusi agar masalah pada perangkat dapat ditangani.
Pada pengembangan Minions, basis data PostgreSQL digunakan untuk mencatat subtugas. Komunikasi antara perangkat dan server memanfaatkan permintaan berbasis API. Sebagai bagian dari proses pemrosesan, hasil dan masukan pekerjaan ditempatkan dalam penyimpanan objek. Saat executor mengambil pekerjaan, komputer tersebut mengambil data yang diperlukan dan mengunduh model yang belum tersedia secara lokal. Sesudah proses selesai, data hasil pemrosesan diserahkan ke sistem. Arsitektur berbasis komponen ini membantu membagi tanggung jawab antarbagian.
Potensi Chip Apple Silicon dalam Pemrosesan AI Terdistribusi
Penggunaan prosesor Apple dalam Minions memanfaatkan akselerator grafis bawaan perangkat. Komputer Mac modern mendukung berbagai pekerjaan pembelajaran mesin. Ketika perangkat digunakan untuk pekerjaan ringan, kapasitas GPU tersebut tidak selalu dimanfaatkan sepenuhnya. Pendekatan penelitian ini mencoba menggunakan sumber daya pemrosesan yang tersedia untuk menjalankan pekerjaan inferensi. Dengan cara tersebut, organisasi memiliki alternatif sumber daya AI tanpa selalu membeli GPU khusus baru.
Dalam membaca hasil penelitian ini, penting diketahui bahwa Minions dikembangkan terutama untuk pemrosesan model yang sudah tersedia, bukan pelatihan model besar secara terdistribusi pada implementasi yang dipaparkan. Proses inference merupakan proses menjalankan model untuk menghasilkan prediksi atau respons. Dalam implementasi Minions, salah satu tugas yang didukung adalah pembuatan embedding menggunakan jaringan neural transformer yang tersedia secara terbuka. Selain itu, Minions mendukung generasi teks melalui model bahasa dengan bantuan Ollama pada perangkat yang berpartisipasi. Pilihan tugas inferensi ini menggambarkan sasaran sistem secara lebih spesifik.
Potensi Penghematan Sumber Daya dengan Komputasi Terdistribusi Apple
Salah satu alasan utama pengembangan Minions adalah tingginya permintaan terhadap akselerator AI. Apabila permintaan inferensi meningkat, pengguna dapat menghadapi waktu tunggu panjang. Dalam pengalaman operasional yang dibahas, antrean GPU tertentu pernah mencapai waktu tunggu di atas sepuluh jam. Melalui distribusi pekerjaan ke Mac menganggur, antrean tertentu dapat berkurang menjadi beberapa menit. Perlu ditekankan bahwa, kecepatan setiap tugas masih bergantung pada kondisi sistem. Ketersediaan GPU harus diperhitungkan.
Selain mengurangi antrean, Minions dapat membantu menggunakan aset teknologi secara lebih maksimal. Komputer Mac yang dimiliki organisasi sering menjalankan tugas utama pengguna. Pada waktu beban kerja lokal sedang ringan, sumber daya grafis berpotensi menjalankan inferensi tambahan. Walaupun mengurangi kebutuhan pembelian perangkat baru, penghematan biaya tidak dapat diasumsikan secara otomatis. Daya yang diperlukan selama inferensi, pemeliharaan perangkat, dan dampak terhadap pekerjaan pengguna tetap menjadi faktor penting. Dengan evaluasi yang tepat, pendekatan Minions dapat membantu memaksimalkan aset komputasi.
Tantangan Keamanan dan Masa Depan Komputasi Terdistribusi Minions
Walaupun komputasi GPU terdistribusi terlihat menjanjikan, keamanan dan privasi tetap menjadi perhatian penting. Saat tugas dipindahkan ke perangkat dari tim berbeda, organisasi harus mempertimbangkan batasan keamanan. Dalam pembahasan mengenai Minions, terdapat kekhawatiran mengenai informasi yang dijalankan pada Mac di luar tim pemilik. Kekhawatiran tersebut menunjukkan pentingnya pengendalian akses. Mekanisme seperti verifikasi identitas node, pengendalian informasi rahasia, serta audit penggunaan sumber daya. Tanpa pengamanan yang sesuai, efisiensi sistem dapat dibayangi persoalan keamanan informasi.
Untuk pengembangan masa depan, tim Apple membuka kemungkinan perluasan sistem dari inferensi menuju proses training jaringan neural. Perlu dipahami bahwa, kemungkinan tersebut belum menunjukkan implementasi produksi. Para peneliti juga membahas kemungkinan menggabungkan Mac dari berbagai organisasi apabila persyaratan keamanan dapat dipenuhi. Gagasan federasi sumber daya tersebut berpotensi membentuk jaringan GPU bersama. Meski demikian, tidak ada dasar untuk menganggap semua perangkat Mac telah bergabung dalam sistem. Kelayakan penerapan yang lebih luas ditentukan oleh kemampuan mengelola sistem yang semakin kompleks.
Kesimpulan: Apple Minions Membuka Peluang Komputasi AI yang Lebih Efisien
Inovasi virtual GPU cloud berbasis Apple Silicon memberikan gambaran baru dalam pengelolaan infrastruktur AI modern. Melalui pemanfaatan kapasitas Apple Silicon yang belum digunakan, Minions berpotensi mengurangi antrean pekerjaan tanpa menambah perangkat GPU khusus untuk seluruh beban kerja. Dukungan eksekusi subtugas yang fleksibel memberikan keunggulan arsitektural ketika jumlah node yang aktif berfluktuasi. Kendati menawarkan peluang efisiensi, perlindungan data serta pengelolaan energi membutuhkan evaluasi. Selain itu, kemampuan pelatihan model terdistribusi masih termasuk arah pengembangan. Seberapa menarik menurut Anda riset Apple Minions? Silakan bagikan pendapat Anda mengenai masa depan komputasi terdistribusi.