Agent Evaluators Makin Penting di Era AI Agent, Akurasi dan Keandalan Jadi Fokus Utama
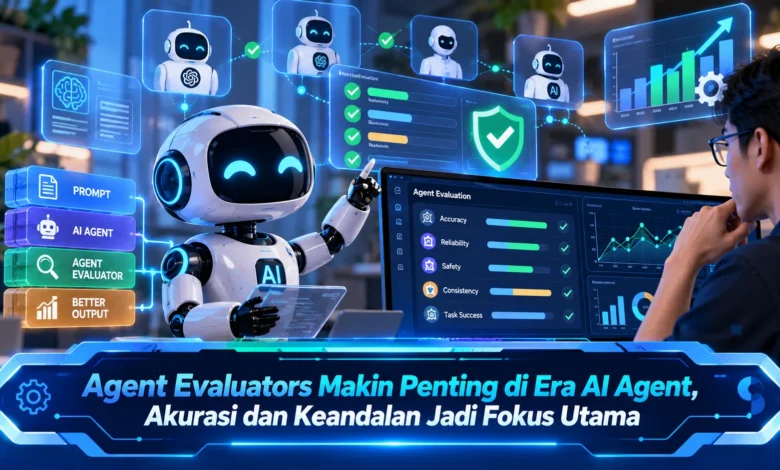
Perkembangan AI Agent membuat kecerdasan buatan semakin mampu menjalankan tugas yang panjang, menggunakan berbagai alat, mencari informasi, dan mengambil keputusan secara mandiri. Kemampuan tersebut juga menghadirkan tantangan baru karena hasil yang terlihat benar belum tentu berasal dari proses yang akurat dan konsisten. Agent Evaluators kemudian menjadi bagian penting dalam perkembangan teknologi AI karena membantu mengukur kualitas, akurasi, keandalan, dan keberhasilan agen dalam menyelesaikan tugas secara lebih sistematis.
Teknologi Agent Evaluators Membantu Mengukur Kinerja AI
Sistem evaluasi AI Agent digunakan untuk menganalisis bagaimana agen kecerdasan buatan menangani serangkaian pekerjaan. Pengujian tersebut dapat mencakup bukan hanya keluaran terakhir, tetapi juga langkah yang ditempuh ketika agen menyelesaikan pekerjaan.
Sistem evaluasi tersebut menjadi semakin dibutuhkan karena AI Agent dapat menjalankan berbagai langkah secara mandiri. Tanpa pengujian yang konsisten, praktisi AI dapat mengalami kendala untuk mengetahui apakah sebuah agen benar benar andal atau hanya memberikan hasil baik pada skenario terbatas.
Akurasi Menjadi Fokus Utama dalam Evaluasi AI Agent
Ketepatan merupakan bagian dari aspek mendasar dalam mengukur kinerja agen. Agen yang menjalankan instruksi perlu memberikan keluaran yang tepat berdasarkan instruksi yang diberikan. Ketidaktepatan informasi dapat mempengaruhi keandalan sistem, terutama ketika tugas memiliki beberapa keputusan yang saling berhubungan.
Sistem pengujian agen dapat membantu memeriksa apakah hasil yang diperoleh sesuai dengan hasil yang diharapkan. Pengembang kemudian dapat menggunakan data evaluasi untuk mendeteksi ketidaktepatan dan memperbaiki sistem secara lebih berbasis data.
Keandalan Tidak Hanya Ditentukan oleh Satu Pengujian
Sistem AI yang konsisten sebaiknya mampu menjalankan instruksi dengan pola yang sama dengan tingkat kualitas yang stabil. Keberhasilan satu kali belum tentu memadai menggambarkan keandalan keseluruhan, terutama ketika kondisi pengujian bervariasi.
Evaluasi berulang dapat membantu mengukur seberapa andal agen dalam menghadapi variasi tugas. Cara seperti ini juga dapat membantu menemukan kelemahan tertentu yang mungkin tidak terlihat ketika teknologi hanya dievaluasi secara sederhana.
Penggunaan Tool dan Langkah Kerja Perlu Ikut Dinilai
Sistem agentic AI dapat memanfaatkan berbagai tool untuk menjalankan tindakan. Agen mungkin memilih alat tertentu, kemudian memproses hasilnya sebelum mengambil keputusan lanjutan. Karena itu, ketepatan pemilihan tool menjadi bagian penting dalam evaluasi.
Teknologi evaluasi agen dapat diterapkan untuk memeriksa apakah agen menjalankan fungsi yang sesuai, mengambil langkah yang efisien, dan menjaga proses tetap relevan. Evaluasi proses membantu pembuat sistem memperoleh gambaran lebih lengkap mengenai performa AI Agent.
Skenario Dunia Nyata Membuat Evaluasi Lebih Bermakna
Efektivitas penilaian sangat ditentukan pada kondisi pengujian. Jika agen hanya menghadapi instruksi yang sangat jelas, hasil evaluasi mungkin tidak sepenuhnya menunjukkan bagaimana sistem bereaksi ketika menghadapi kondisi tidak terduga.
Pengujian yang beragam dapat mencakup instruksi bertahap, kesalahan proses, serta kebutuhan untuk menyesuaikan tindakan. Dengan variasi semacam ini, Agent Evaluators dapat menyediakan penilaian yang lebih mendalam mengenai akurasi teknologi AI Agent sebelum diterapkan dalam pekerjaan nyata.
Rangkuman
Sistem evaluasi agen pintar menjadi semakin relevan ketika AI Agent mulai menangani lebih banyak pekerjaan. Ketepatan hasil, stabilitas performa, penggunaan tool, dan ketepatan langkah perlu diukur secara terstruktur. Dengan skenario yang realistis, teknologi evaluasi dapat mendukung pengembang mengidentifikasi kesalahan dan menyempurnakan kemampuan AI Agent secara lebih berbasis data. Tuliskan pandangan Anda mengenai Agent Evaluators dan kemampuan apa yang menurut Anda harus menjadi prioritas ketika menilai sistem agen pintar.